
关于我的陈年老项目SFC
原文:关于我的陈年老项目 · bilibili 专栏 作者:ReTraumenD 编辑于 2026年09月12日 02:09
SFC(压缩软件,见半年前动态)大概以后都不会再有更新了。
经过数个月对 unity 的摸索,cpp 也是生疏了有些,然后也是借着实习面试受挫的这个契机,我稍微有动力去继续维护项目了。
https://gitee.com/fifseason/We_compress
现在是 2.2.1 版,用多线程流水线+算法优化加速了处理,吞吐量已经优化到了原来单线程版本的数十倍(?
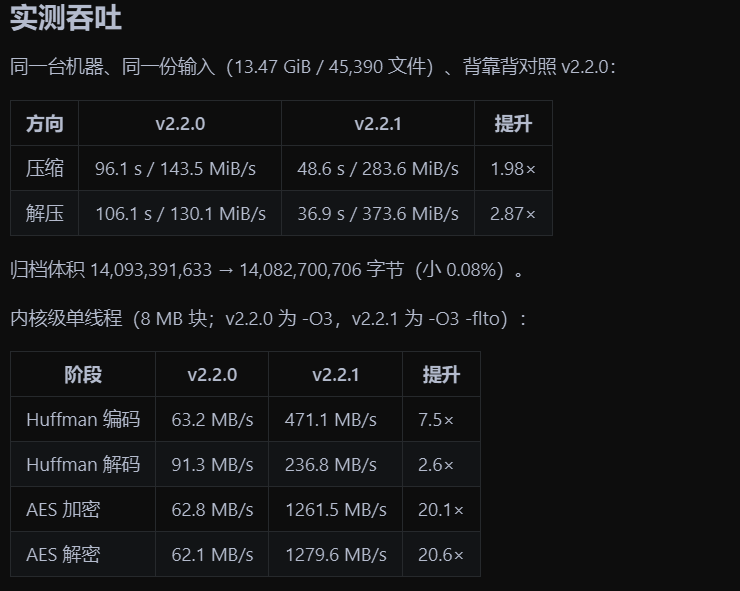
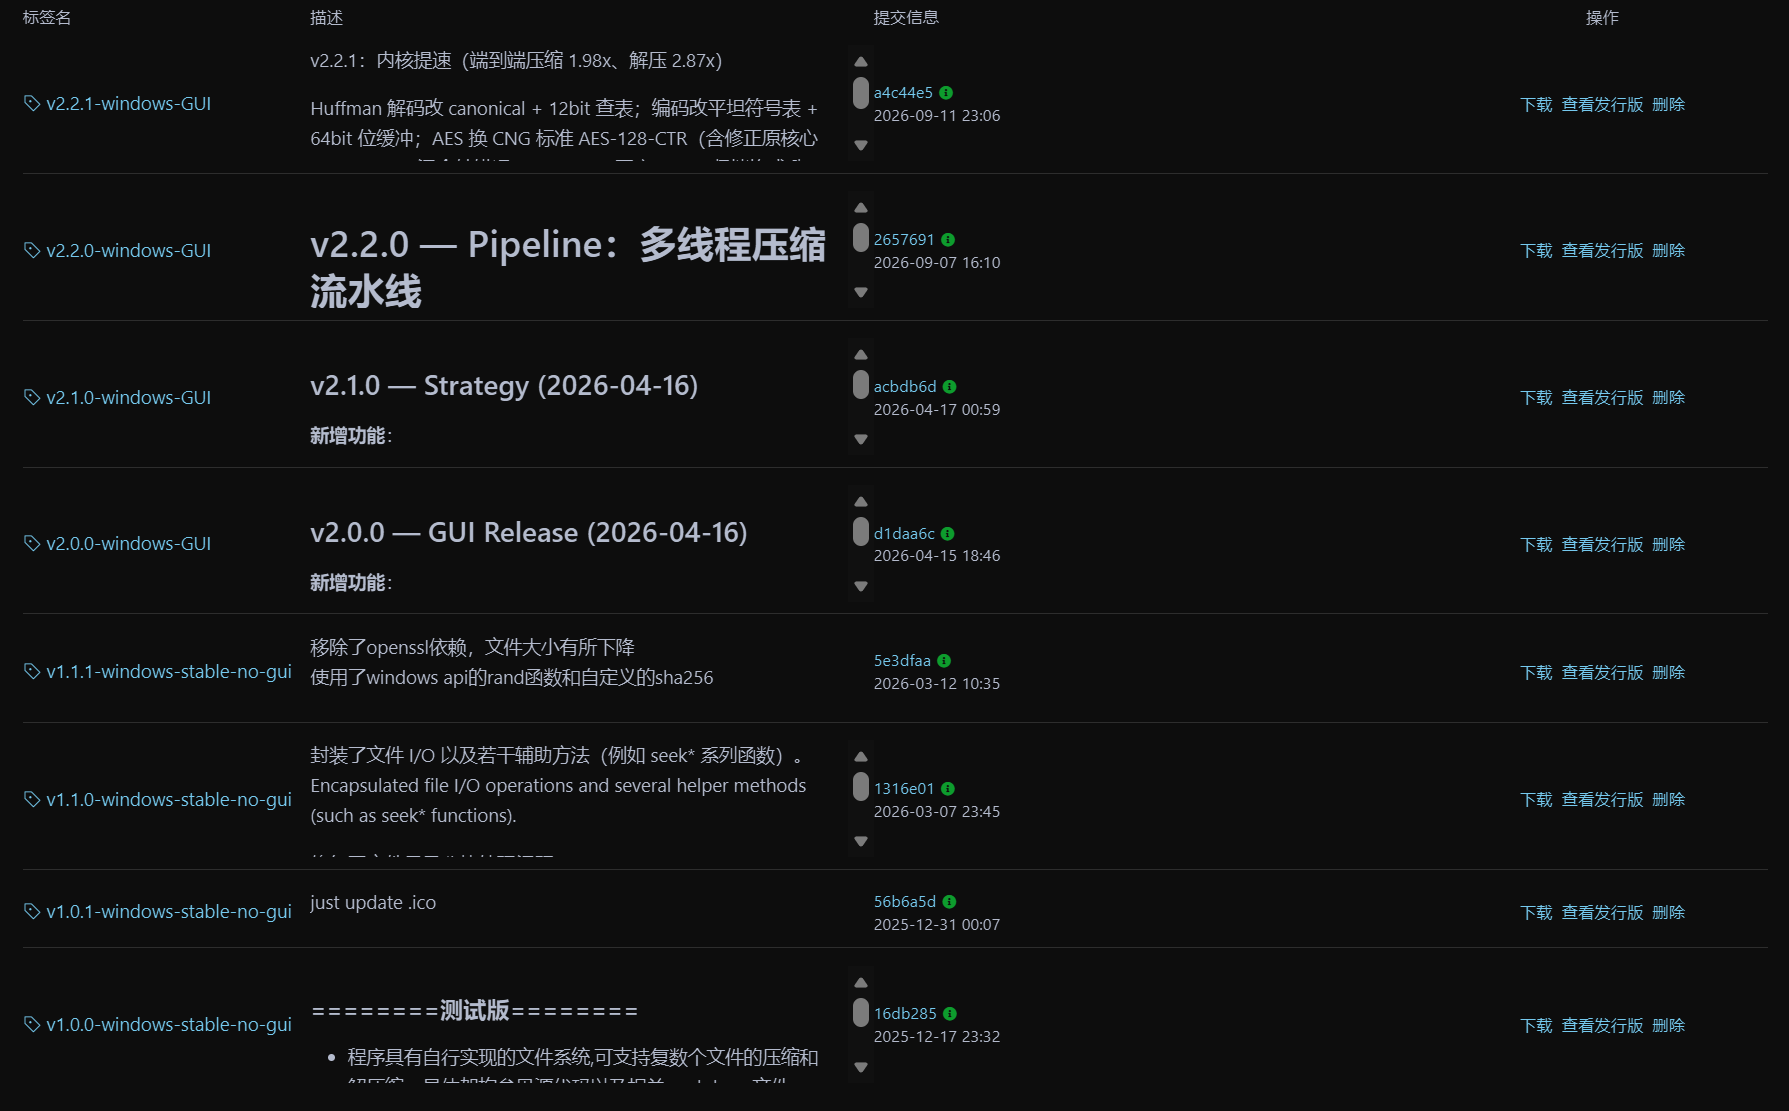
SFC 除了算法差点,速度其实已经向成熟方案靠齐了,不过这一大步只有我 10% 左右的学习在里面吧……因为大多时候我只是心血来潮弄一下。 除了线程模型的学习、架构、格式设计以外,剩下的工程问题几乎都是 ai 实现了,没想到只是一年时间,ai 的能力如此爆发,并且还能走进千家万户(指程序员)。
期待并且担忧着吧我也是,这个项目大概是真的要结束了,接下来会比较重视 unity 这块,看能不能在 ai 时代端起这碗饭了……
说真的,我也不知道维护这个项目的意义何在,可能就是个大玩具的存在这样。
起初只是大二想结合朋友的压缩实现和我对密码学的一些兴趣来做一款压缩软件,不过具体是谁牵头我也记不清了。
当时甚至花不少时间来探讨了实现方案,现在看来可能是稍微有些长期的收益吧,锻炼到了思维能力、沟通能力什么的,面试见得,我实际上也讲不出来,很难受 xd。(纠正——其实能稍微讲讲,就实习面试而言我的表达能力没问题)
然后大二上那个学期也是结合数据结构和软件工程导论的知识来做这个软件了——效果其实不错,很多知识都有用上,让我对数据结构和一些软件工程知识有了更具体的认识。
比如说用队列解耦生产消费,我的文件头扫描器的实现就是靠这个做步进和状态控制的(一种类似迭代器的用法)。
此外数据结构也启发我去做了 BFS 的文件结构,受到位图启发,在扁平化目录结构的时候用标识符和计数等等。
实际上去看标准实现之后才发现标准实现的取舍,这里可以分几点说:
一方面是:
工程难度的取舍:BFS 方案的工程难度实在是夸张,我自己搓用了大概两月,写下 ~2000 行代码实现它的构造、写入、解析。
当时还花几百块大价钱接中转 api 来 debug(可恶 a\ 还我生活费),一些高级特性的误用倒是轻松拿下了。关于归档系统的 bug 却是怎么也找不到!
当时那玩意只会 u r absolutely right! 给我气哭了,几个月后我不信邪,自己古法打日志加断点调试找出病灶修好的。
后面查询开源方案得知我的这个真真是奇形种实现方案,是真的没有现成参考——不过这是写这篇文章近期的事情了,倒也给我点安慰。
中间还被平台依赖折磨——例如文件系统的路径长度限制在 260B 以内这种。
还有就是编码问题,当时真的没有很好的解决办法。是后续让ai结合qt出的兼容层——要是早点能出这个兼容层也就不会卡我这么久了,初期有一两天就是被这东西卡着,那时候为了避开filesystem甚至尝试了POSIX,当然后面换回来了(POSIX的封装太少,用起来让人抓狂,,,
这里面我自己悟出的一些设计哲学就是 利用迭代器方式去解耦的生产消费和控制流。
这是通过迭代方法done()等实现的一种可见性规范——纯粹的控制流、封装了实现方法。
在速度上也由队列进行缓冲,队列里有时,内部控制流不会继续迭代下去,队列里空时,按规则迭代一轮,可能放入很多块,但是一定有,一旦有就做完本轮即止,不进行下一轮。
消费者每次需要时只是用next()方法取出,就如上述机制那样,封装好的控制流会自动迭代并且给出指定内容。
上述实践方案虽然只是遇到了不可调和的解耦之后再实装的,不过这种设计哲学确实实实在在地让我学到了很多的工程知识,后来也运用到了A*的路径获取器里。
另一方面是:
功能性角度的取舍:哈希这类桶算法在这的最大优势就是随机访问,BFS 在存储空间占用这一块几乎是最好的方案,但是它有一个弊端,它实际上是用顺序结构承载了层次信息,也就是文件的路径索引。 所以如果想实现随机访问的话(例如打开文件夹临时访问),几乎需要完全遍历并且在程序中重建目录树——这很慢。
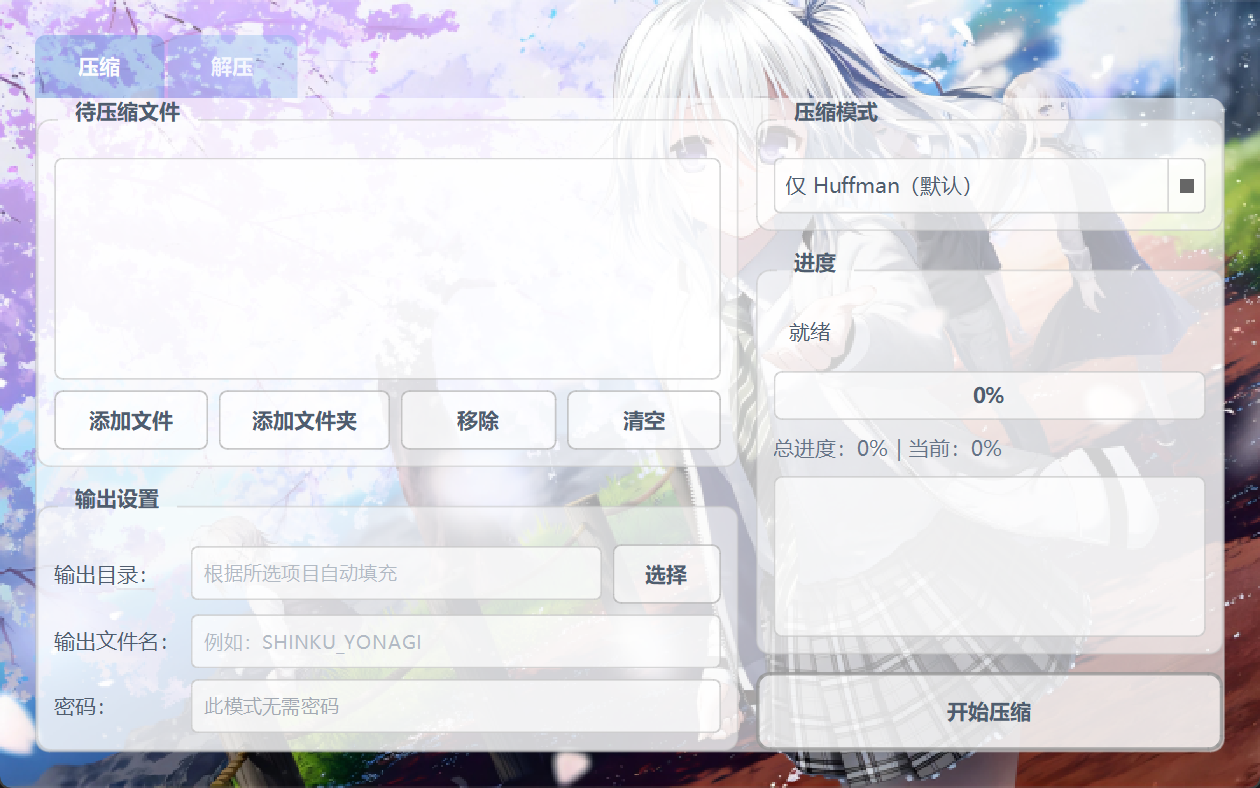
还有 QT GUI:
这个懒得喷好吧,作为前端技术各种信号槽什么的玩意,难得一批,评价为前端里的 UE。做这部分工作的时候我完全是一个 GUI 产品经理来推进产品了:这个按钮的字怎么没有居中?这字的间距不对啊?把框搞一个缺口!这字体好糊啊!按钮朝左移动五毫米!……
总之用我的眼睛和键盘调出一个还算能用的布局这样。
不过其实很多时候都是作为一个略懂技术的产品经理在做事?或者说是架构的敲定者这样。
还有就是线程模型:
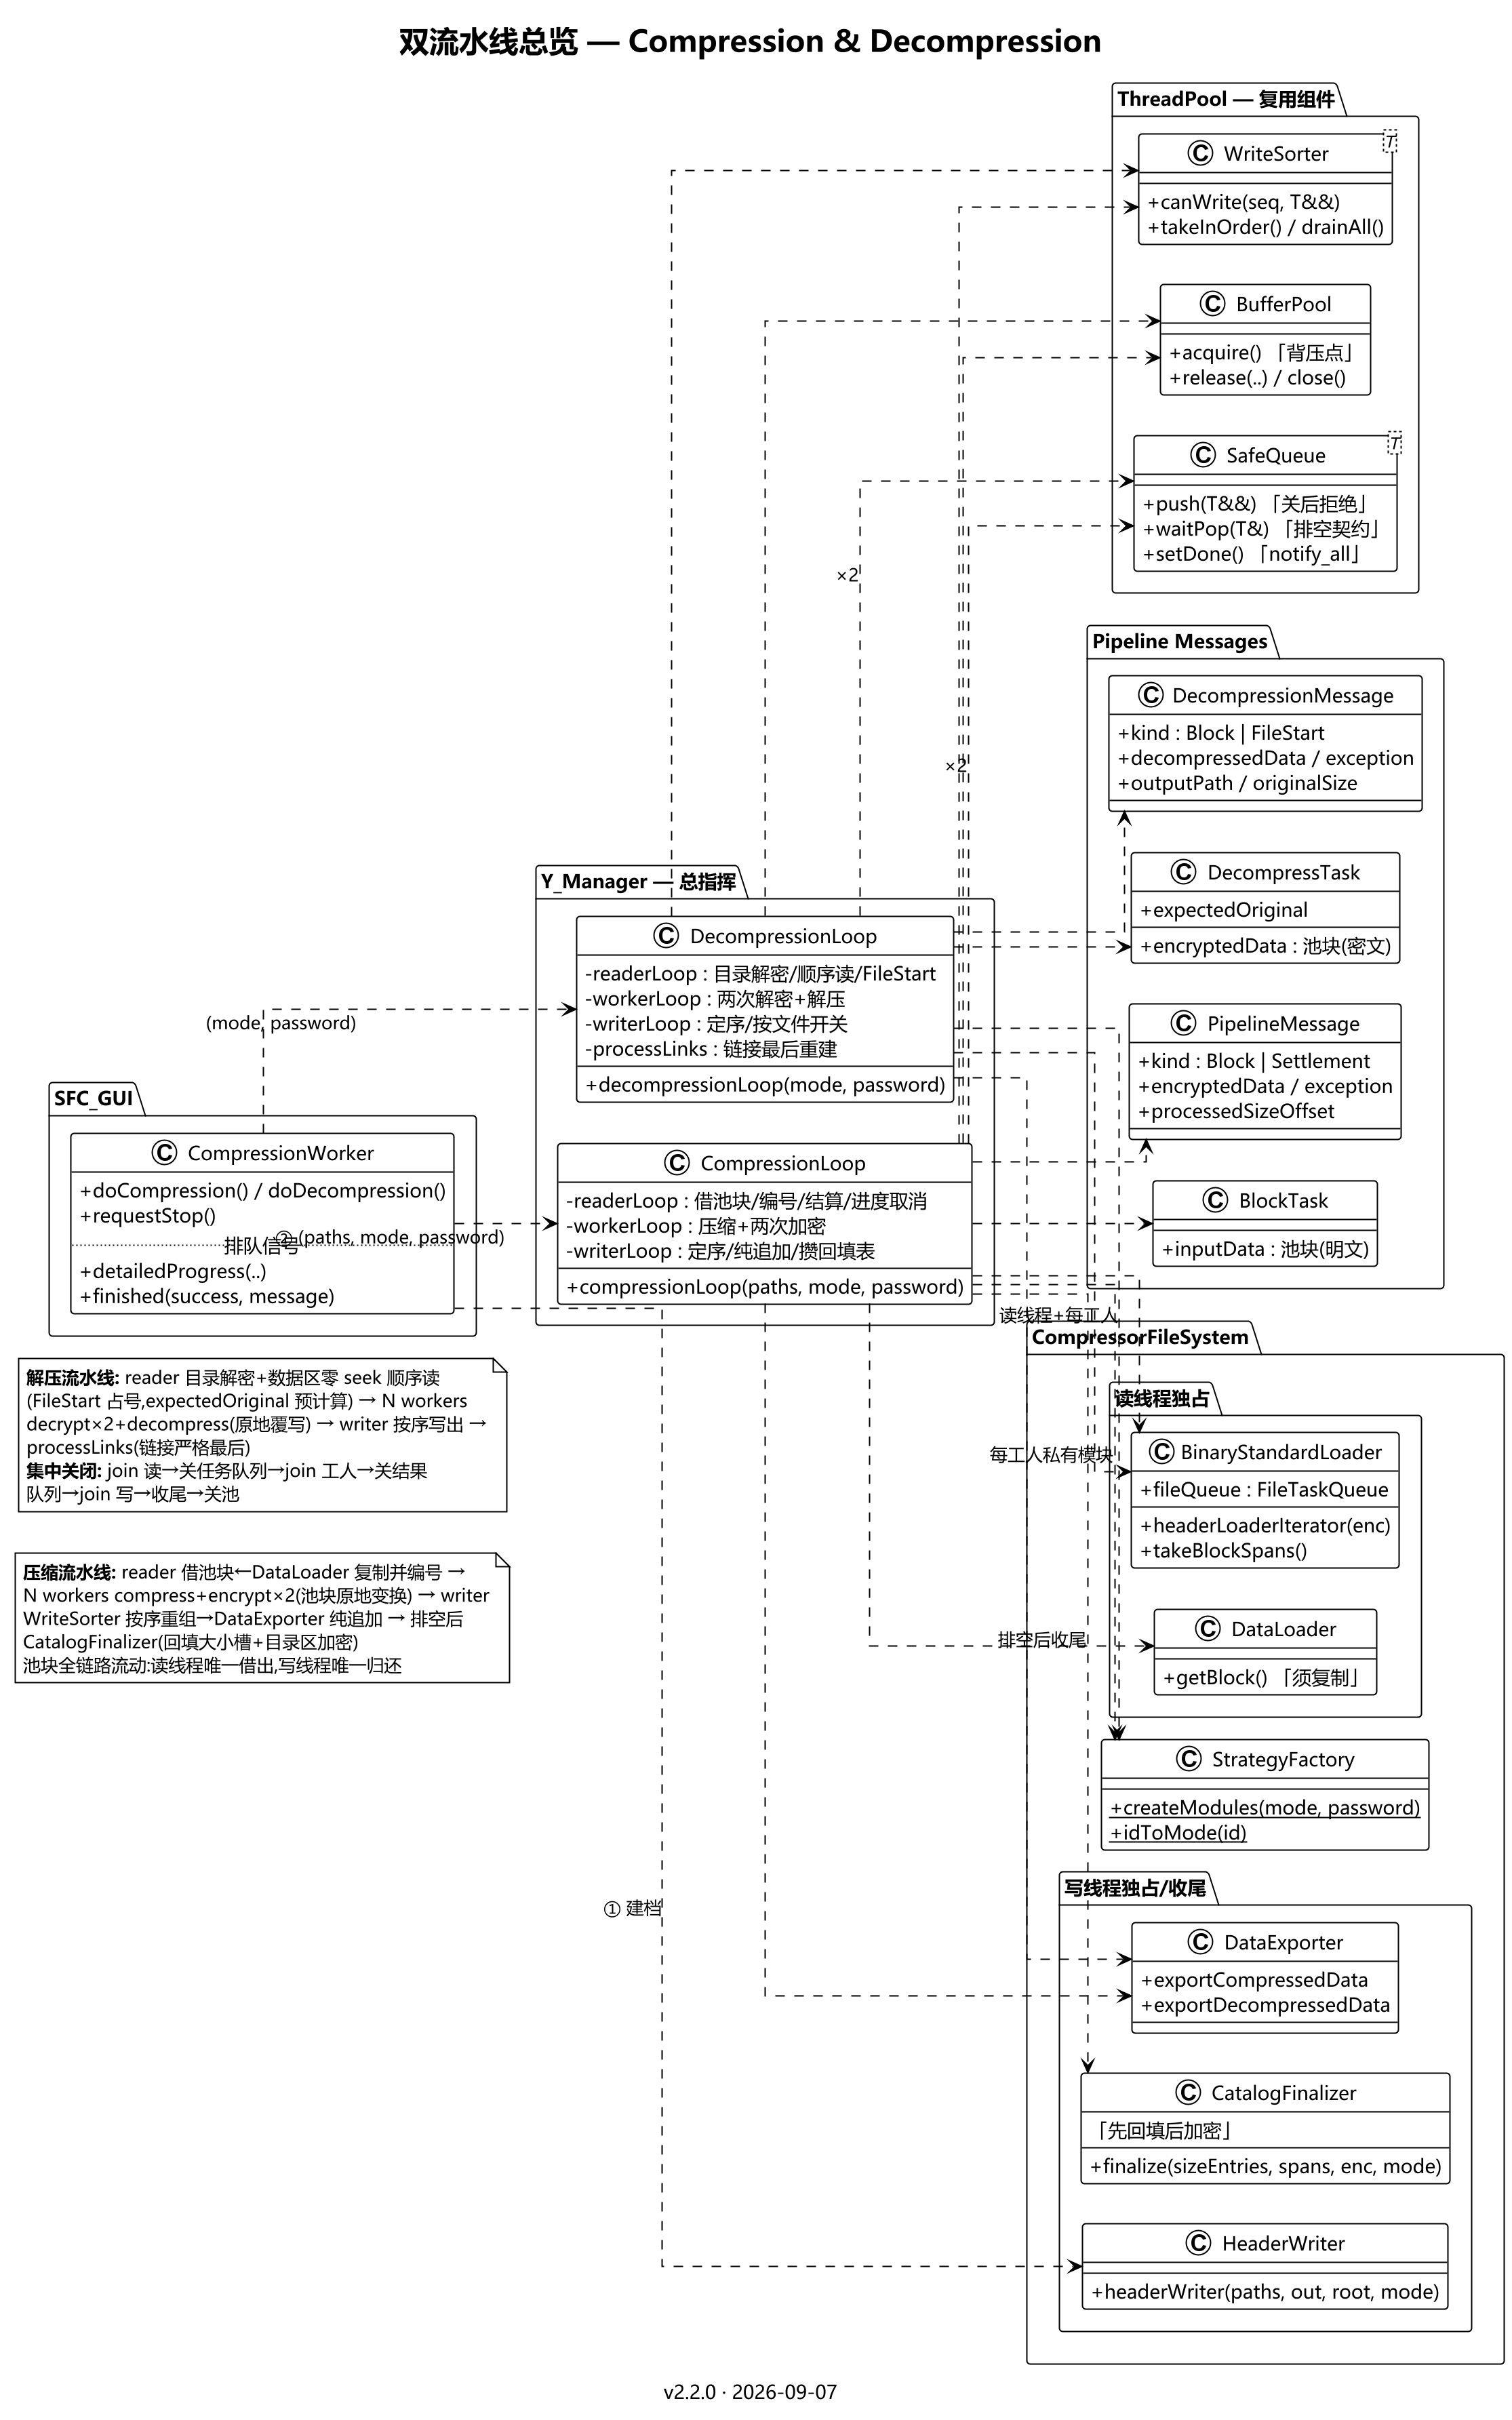
主流的一些实现方案是非常值得学习的,例如线程模型,虽然说最近才开始在意,但是也算亡羊补牢,为时不晚。
具体的实现:
专职读线程 ──任务队列(SafeQueue)──> N 个计算工人 ──结果队列(SafeQueue)──> 专职写线程接着读写线程分别向 bufferpool 借/还数据块——这里很关键,只要限定总的块数量,就可以使得背压自动地从消费端传导到生产端,很好地解决了复杂的资源调度问题。
写线程虽然会按序号阻塞到达乱序到达的数据块,但是还是获得了相当程度的吞吐量提升,正常情况下能抹去临界区的成本。
关于临界区我也稍微提一嘴,并发编程的东西还是需要测试为主导哇,不测试是很难搞清楚所谓的效益究竟到了什么地步的,例如我上述的简易算法面对大量小文件的时候,cpu 并行计算的优惠就抹平不了调度成本了,需要引入合批技术来确保足量的 cpu 任务负载,但是这个又是刚需动态调整的,难搞,所以还是罢了(((,,,以后也鸽了,永远不会实装好吧。
结语
可以说这个学期里还是学到了不少东西的,也给我的 unity 学习打了基础了。
甚至 A* 的实现就有上述提到的队列思想——用队列对齐速度,要的时候内部自己算完然后步进吐结果的迭代思维、封装思维,外部根本不管实现是什么。
我其实也拿这个 SFC 的极早期版本交了两个作业,一个是数据结构,当时还没有 GUI,代码也已经 5000 行了——大作业还要求全放上去,我于是拼尽全力压到差不多 50 页的样子。
关于这个项目,我觉得形容金融泡沫的那句话很合适:
低估了长期效益,高估了短期效益
和我合作过的那位朋友这样吐槽:
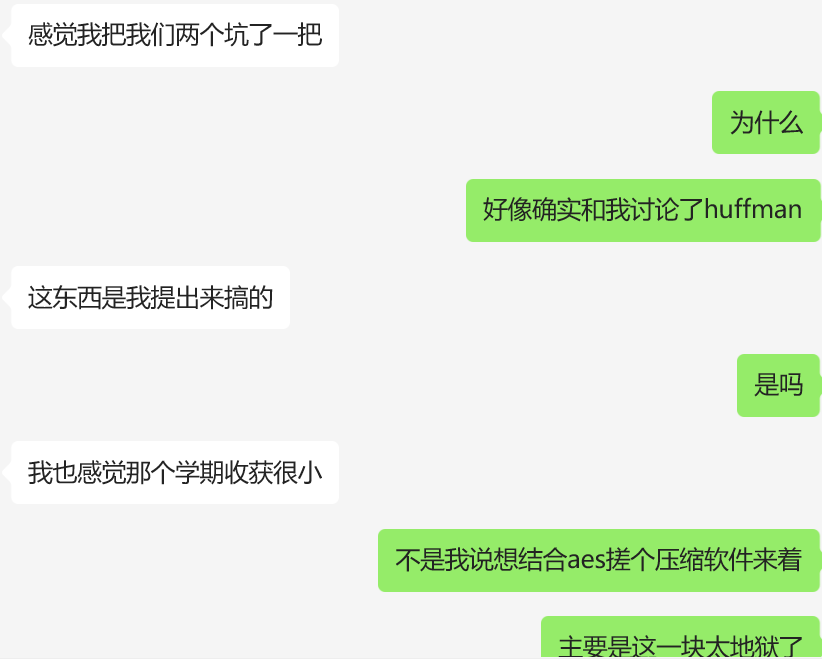
不过回过头来看至少工程能力提升了不少呢(
部分信息可能已经过时
 粤公网安备44011102484817号
